Fundamentals of Machine Learning · Digital lecture note
Lecture 10 – NLP: Tokenization, TF-IDF, Word2Vec
Makine Öğrenmesinin Temelleri – NLP: Tokenization, TF-IDF, Word2Vec
- Course
- Fundamentals of Machine Learning (ELM472)
- Semester
- Semester 7 · Fall 2024–25
- Format
- PDF · 6 pages · 0.3 MB · handwriting-style LaTeX
- Language
- Turkish
- Original note
- Ders-10.pdf
Open the PDF (0.3 MB)LaTeX source (.tex)Original handwritten note
What is in this note?
Section headings of the note (in Turkish):
- NLP (Natural language processing)
- Tokenization
- Word2Vec
- CBOW
- Skip gram / n-gram
- Global vectors for word Representation (Glove)
- Static embedding
- Benim adım Mehmet / Seq 2Seq
- Attention Mechanism
Text of the note
Show as plain text (Turkish; formulas and drawings are not included)
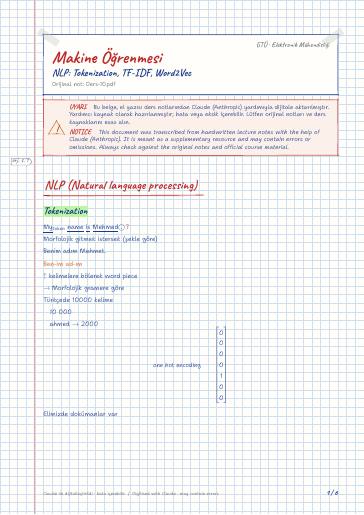
NLP (Natural language processing)
My token name is Mehmed. ?
Morfolojik gitmek istersek (şekle göre)
Benim adım Mehmet.
kelimelere bölerek word piece
→ Morfolojik gramere göre
Elimizde dokümanlar var
Tüm dokümanlarda iki kelime aynı frekansla geçmemeli
TF-IDF → baskınlığı azaltmak için
Continuous Bag of Words
Skip gram / n-gram
2 gram iki komşuluk
tersten de yapabilirim
Global vectors for word Representation (Glove)
Covid geldi yeni kelime
Benim adım Mehmet / Seq 2Seq
RNN → exploding vanishing unutma fazla
sonraki güncellemede LSTM
Bu metin kısa olmadıktan sonra context'i yakalayamıyor.
kelimeleri hidden layerle çarpıyoruz
hangi kelime ne kadar önemli
sonra dönmek yerine MLP koyuyoruz
2019BERT: Sadece Encoder , kelimeleri ayırabilirsin
BERT NLP'nin YOLO'su
BERT : Bidirectional Encoder Representations from Transformers
ELMO: Embeddings from language model
context mekanizması yok